列指向データベースと行指向データベースの選び方

データベースのパフォーマンスは、選択するデータベースストレージの種類に大きく依存します。多くの組織では、行データベース、列データベース、またはその両方を組み合わせて使用しています。
行指向データベースは、特にトランザクション処理など一部のアクセスパターンに適しており、列指向データベースは分析処理に向いています。
行指向データベースと列指向データベース、どちらのデータベース型を選ぶかは重要な判断です。両者のメリットとトレードオフを十分に検討し、自社の利用ニーズを分析したうえで慎重に決定する必要があります。
この記事では、列指向データベースと行指向データベースの違いとそれぞれの仕組みを解説します。また、両者のメリット・デメリットと、分析チームにとって列指向データベースが優れている理由についても説明します。
[CTA_MODULE]
行指向データベースとは
行指向データベースは、主にストレージを目的とした従来のデータベース管理システムで使用されます。行ストアまたは行指向データベースでは、データは行単位で格納されます。つまり、ある行の最初の列のデータは、前の行の最後の列のデータの直後に配置されます。具体例で説明します。“トップ顧客”というテーブルのデータを格納する場合を考えてみましょう。
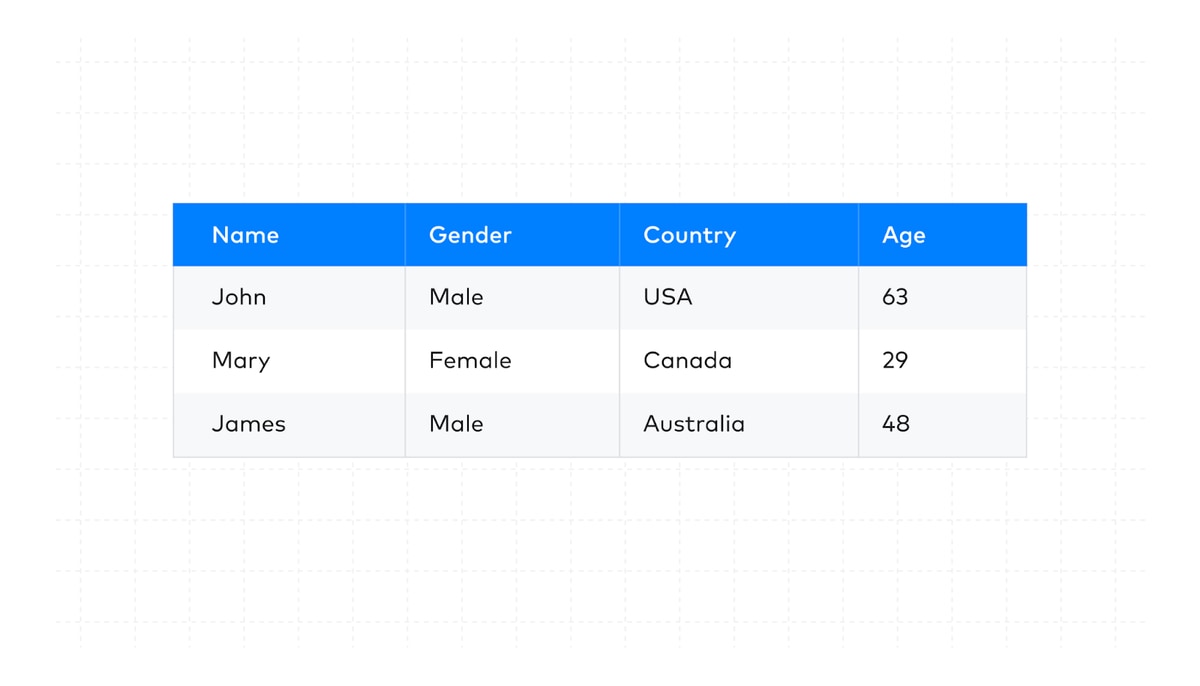
行指向データベースでは、次のように格納されます。
John、男性、米国 63 | Mary、女性、カナダ 29 | James、男性、オーストラリア 48 |
ここで「|」はブロックの終端を示しており、そのブロック内のすべてのデータが一括して格納されます。
データをブロックと行に分割して管理するこのディスクストレージ方式は、トランザクションクエリに最適です。
そのため、行指向データベースはオンライントランザクション処理(OLTP)に広く使用されています。少量のデータを用いて、挿入・削除・更新などの単一の「トランザクション」を高速に実行できます。
MySQL や Postgres などの行ストアは、行内のすべてまたは大部分のデータを使用する場合に適しています。データエンジニアは、フルテーブルスキャンを回避または高速化してクエリを最適化するために、インデックスを活用します。これは、アクセスパターンに基づいて列からユニークキーを作成する手法です。
メリット
データ変更の簡素化
行指向データベースでは、データが個別のブロックに格納されているため、新しいデータの追加や既存の値の変更が容易です。新しいデータは、直前のブロックの末尾に追記されます。例として、“トップ顧客”データに新しい値を追加する場合を考えてみましょう。
表示例は次のとおりです。
John、男性、米国 63 | Mary、女性、カナダ 29 | James、男性、オーストラリア 48 | Kate、女性、英国 38 |
この方式では、データブロック全体を一度に削除できるため、行の削除も容易です。
OLTP に最適
行ベースのデータベースは、単一行の処理に優れています。高度な並行環境における高速かつ効率的なオンライントランザクション処理向けに設計されており、多くの場合、インデックスが多数設定されています。
デメリット
データ集約の低速化
行指向データベースは集計処理が苦手です。関連するデータを抽出して活用するには、すべての行のデータを先にロードする必要があるためです。
例えば、“トップ顧客”テーブルから男性顧客の平均年齢を取得する場合、行ストアを使用すると、まずすべての顧客データをロードしてから、必要なデータを抽出することになります。
圧縮不足
行指向データベースでは、異なるデータ型を含む複数の行を同時に圧縮する必要があるため、圧縮メカニズムの効率が低下します。圧縮効率が低いと、大量のデータの処理が困難になります。
追加スペースが必要
行指向データベースは効果的に圧縮することができないため、列指向データベースと比較して大幅に多くのストレージ容量を必要とします。データそのものに加え、複数のインデックスを使用することで余分なストレージ領域を消費します。
列指向データベースとは
列指向データベースは、各列のデータをすべて単一のブロックとして格納します。行ストアの水平パーティショニングに対する、垂直パーティショニングとして捉えると分かりやすいでしょう。
例えば、列指向データベースでは“トップ顧客”データを次のように格納します。
John Mary James | 男性 女性 男性 | 米国 カナダ オーストラリア | 63 29 48
列指向データベースにおけるデータの格納方法の例を以下に示します。
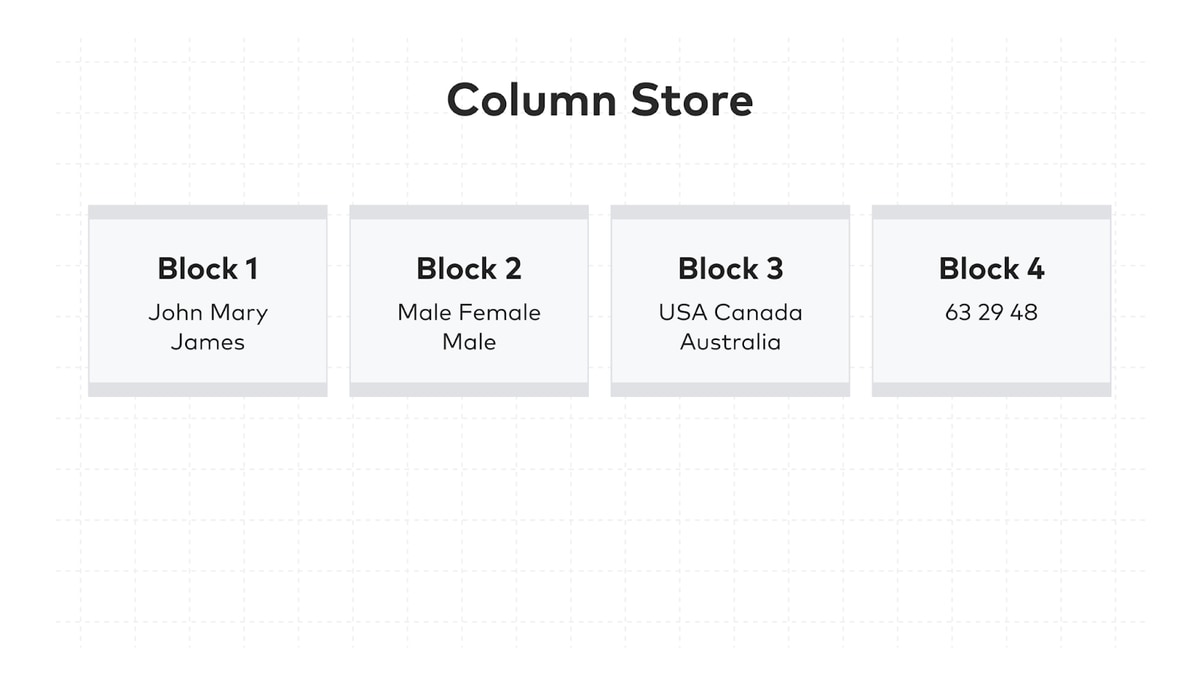
このようにデータを整理することで、データの集計や計算処理が容易になります。このグループの平均年齢を求める場合、特定のブロックのデータを使って直接計算できます。こうした特性から、列指向ストアはオンライン分析処理(OLAP)に適しています。
メリット
OLAP アプリケーションに最適
列ベースのストレージを使用するデータベースは、行ベースのストレージを使用する同等のデータベースと比べて大きな利点があります。大量のデータを処理する分析クエリにおいて、クエリのパフォーマンスが大幅に向上します。データは、クエリ結果の計算に必要な場合にのみアクセスされます。
Amazon Redshift、SAP HANA、Oracle、Microsoft、Actian の Vector database など、現代の分析・レポーティング用リレーショナルデータベースの多くは、列ストレージを採用しています。SQL ベースのツールを使ったレポーティングを高パフォーマンスで実現したい場合は、列指向データベースの採用を検討してください。
データ集約の高速化
列指向データベースでは、各ブロックに特定のデータフィールドの値がすべて格納されているため、データの集計が高速です。これにより、分析アプリケーションはテーブル全体を検索することなく、複数の列から大量のデータを集計できます。複雑なクエリを伴うことが多い分析ワークロードにとって、高速な集計は不可欠な要件です。
高速圧縮
列指向データベースでは、各列のデータ型が統一されているため、圧縮アルゴリズムの効率が大幅に向上します。各列を単一ファイルとして圧縮できるため、アナリストやデータエンジニアは大量のデータを迅速に圧縮することができます。
必要なスペースを削減
圧縮率が高いほど、データが占めるディスク容量は少なくなります。追加のストレージに投資することなく、多数のデータセットを保存・集計・操作できます。
デメリット
データ変更の低速化
列指向データベースでは、単一行の操作は一般的に効率が低く、行ベースのデータベースと比べて変更処理も低速です。列指向データベースは、挿入・更新・削除(またはマージ)をバッチ操作として処理することを前提とした設計になっています。
例えば、データの行を追加する場合、新しい行の各値を既存のデータベースの正しいブロックに追加する必要があります。列数が多い場合、この処理は複雑になります。
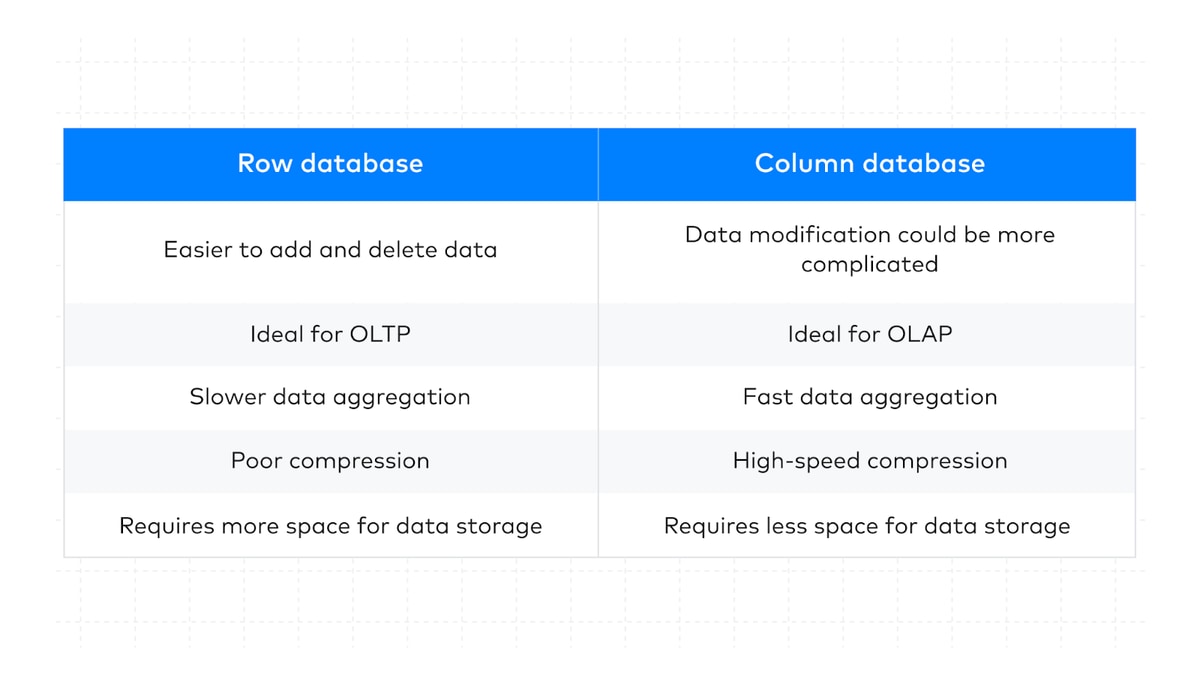
列指向データベースと行指向データベース:主な違い
行指向データベースと列指向データベースの比較をまとめます。
列指向データベースが分析に優れる理由
分析の観点では、列指向データベースが行ストアを大きく上回ります。その理由は3つあります。
圧縮速度
前述のとおり、列指向データベースは行指向データベースと比較して、圧縮する速度が大幅に向上します。
これは分析クエリにとって非常に重要です。アナリストやビジネスインテリジェンスツールが大量のデータを高速に処理し、迅速にインサイトを得られるようになるためです。
アクセスの簡素化
一般的に、分析アプリケーションは複数の列から異なるデータを必要とします。多くの組織では、数百から数千の列と行で構成されるテーブルを保有しています。行指向データベースへのクエリでは、こうしたデータをすべてロードしたうえで、関連するセクションを解析して結果を取得する必要があります。多くの場合、データの変化速度は、行指向データベースがクエリを処理するのに要する時間を上回ります。列指向データベースは、急速に変化するデータへのアクセスを容易にし、アプリケーションが迅速にクエリを解決できるようにします。
より優れたストレージ
列指向データベースでは圧縮メカニズムの効率が高く、ストレージを効率的に活用できます。同じディスク容量であれば、列指向データベースは行指向データベースよりも大幅に多くのデータを格納できます。
列指向データベースでは、データをさまざまな方法でソートすることも可能です。ソート順が設定された列やプロジェクションにより、データが複数回保存されるため、列指向データベースはより高い耐障害性を持ちます。
コストとパフォーマンス
エンドユーザーは常に最高のパフォーマンスと最新のデータを求め、一方で経営層はコストの最小化を優先します。この両者の要件のバランスを取ることは容易ではありません。
コストを度外視できるなら、最大規模の OLTP システム(Oracle Exadata など)を導入し、列指向の最適化オプションを追加することで、単一データベース上での高速トランザクション処理と高性能クエリを両立させる選択肢もあります。しかし現実的には、パフォーマンスとコストのバランスを取るために Amazon Redshift のような代替手段を検討している組織が多いでしょう。
異種データベースレプリケーション
別のデータベースとの同期を維持するには、ほぼリアルタイムのデータレプリケーションが有効です。多くのレプリケーションソリューションは、ソースの OLTP データベースに対して効率的なログベースの CDC(変更データキャプチャ) を実行し、デスティネーションシステム上で SQL 文を使って操作を再現します。
列指向データベースでは、ソースデータベースのトランザクション量が多い場合でも、システムをほぼリアルタイムに最新の状態に保つためのパフォーマンス最適化を適用できます。
列指向データベース向け ELT
ELT(Extract・Load・Transform)プロセスは、ソースからデータを収集してストレージにロードします。その後、アナリストやエンジニアがトランスフォーメーションを適用し、活用可能なデータを得ます。
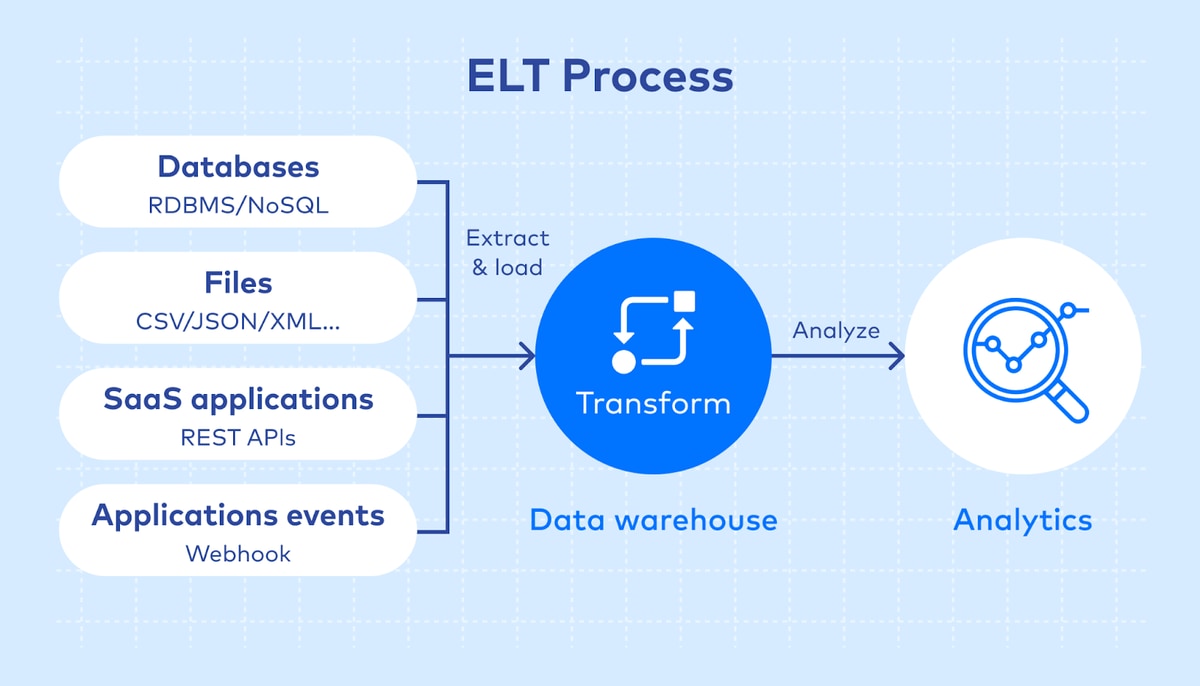
ELT ワークフローは、クラウドデータウェアハウスのような列指向データベースを使用するデータパイプラインに最適です。ウェアハウスやデータレイクハウスへのデータ収集とロードを迅速に行えます。ELT は、より速いデータアクセスを実現し、自動化されたデータパイプラインを可能にします。また、ETL ベースのパイプラインと比較してコストを抑えながら、クラウドデータウェアハウスのネイティブ機能を活用できます。
Fivetran のように、自動化された ELT パイプラインを構築できるプラットフォームは、今も将来も対応できる選択肢です。コネクタを活用することで、Amazon Redshift などの列指向データベースをパイプラインへ手間なく統合できます。ELT パイプラインは、複数のソースから迅速にデータを収集する必要があるモダンな組織にとって、最適な選択肢です。
まとめ
行ベースと列ベースのデータベースは、それぞれ異なる用途に対応しています。しかし、現代のビジネスには速度が求められます。非効率なストレージは分析の低速化を招き、インサイトの創出やイノベーション、事業成長の妨げとなります。
列指向データベースは OLAP アプリケーションに適したストレージの選択肢であり、クエリの高速処理を実現します。多くの企業では、異なるクエリタイプに対応するために行ストアと列ストアを組み合わせて使用しています。データパイプラインは両方のストレージオプションに対応する必要があり、ELT パイプラインはその点で最適な選択肢です。高速なデータ転送とカスタムトランスフォーメーションを実現し、その両方が分析の高度化に貢献します。
関連記事
無料で始める
Fivetran でデータの一元化と変換を実現している、数千社の企業に加わりませんか。